银行营销定期存款订阅预测
在避免通话时长数据泄漏的前提下,比较五类模型以支持银行电话营销资源分配。
只用营销电话前可获得的信息,比较五类模型来支持客户筛选。
01 / 问题
在拨打电话之前,能否更有依据地判断谁值得优先联系?
目标是根据客户特征、历史营销行为和宏观经济变量预测 yes / no 定期存款订阅,并减少无效电话。一个关键限制是 duration 只会在电话结束后出现,因此主动排除出正式预测模型,避免 data leakage。
02 / 数据与建模原则
只让模型看到真实预测时已经可用的信息。
人口与客户特征
营销活动与历史联系
宏观经济指标
YES / NO
EDA 只在 training set 上完成,不提前使用 validation 或 test 信息。
03 / Train · Validation · Test
把训练、选择和最终评估严格分开。
Training 用于拟合五类模型;Validation 用于比较 Accuracy、Sensitivity、Specificity 与 AUC;Test 只在最终模型确定后使用。
04 / 类别不平衡
“No” 明显更多,Accuracy 不能单独决定模型好坏。
因此同时查看 Sensitivity、Specificity 与 AUC:前者关注潜在订阅者,后者关注不太可能订阅的人,AUC 用于整体区分能力。
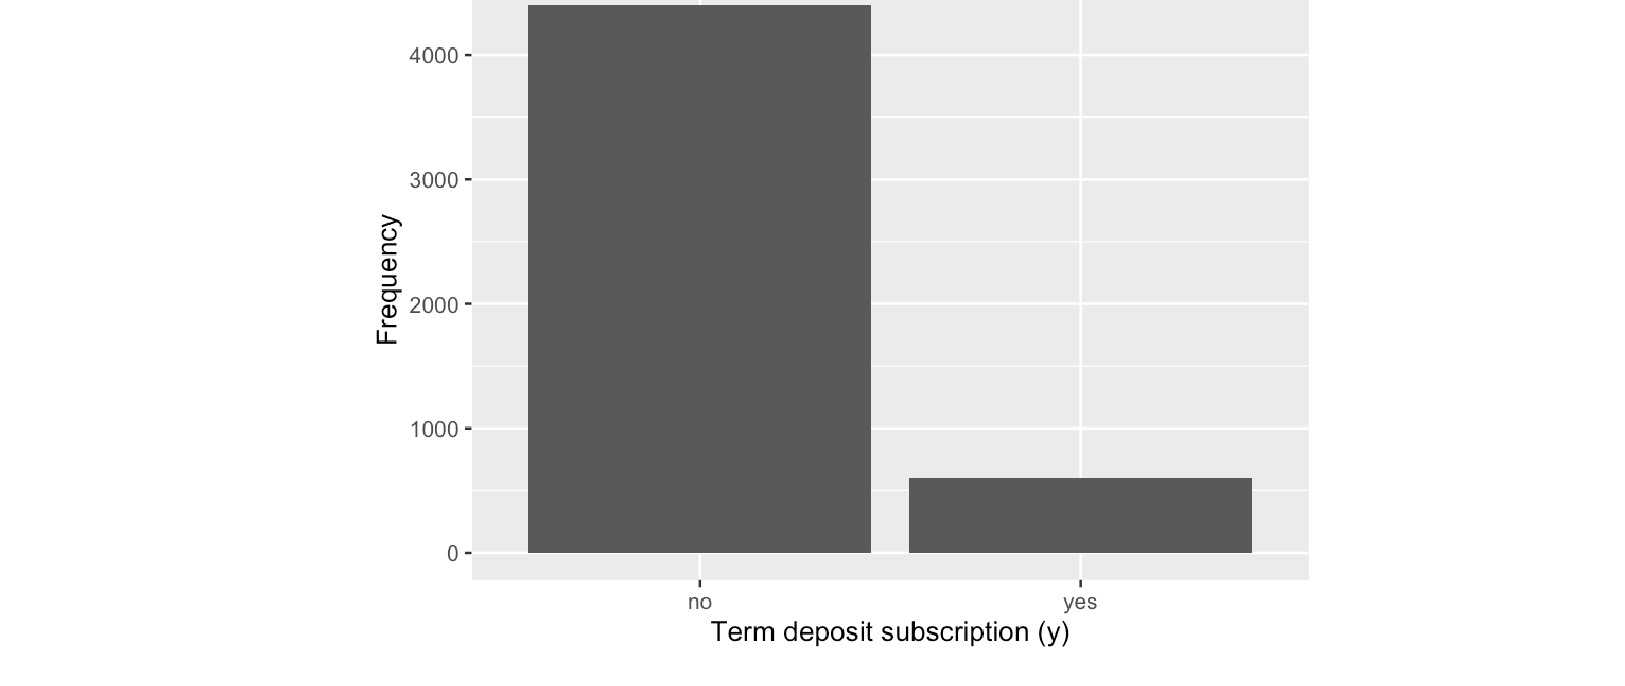
原始分析图:training set 中 response 的类别分布。
05 / 预测信号
历史活动、月份与经济环境都提供了预测线索。
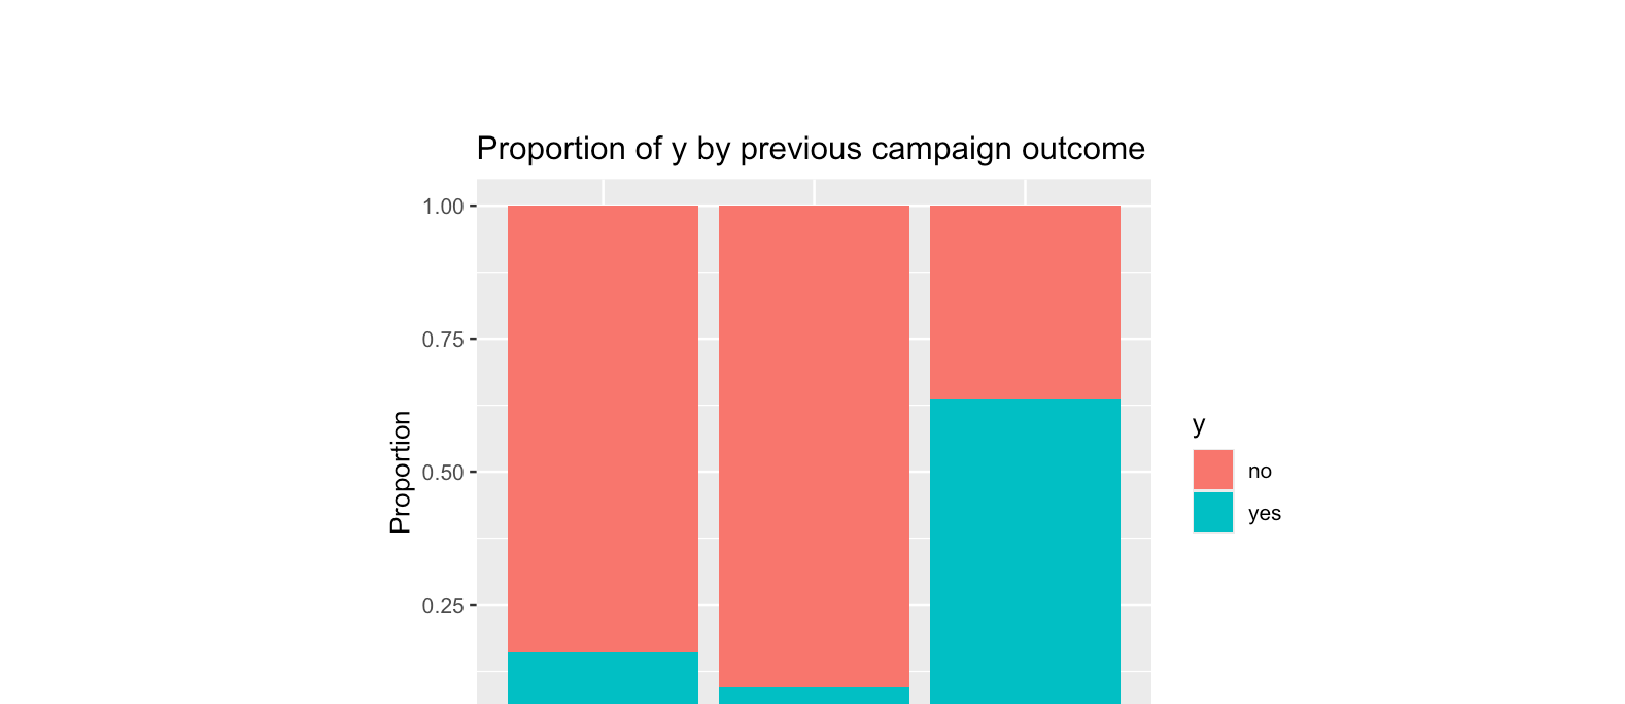
原始分析图:previous campaign outcome 下的订阅比例。
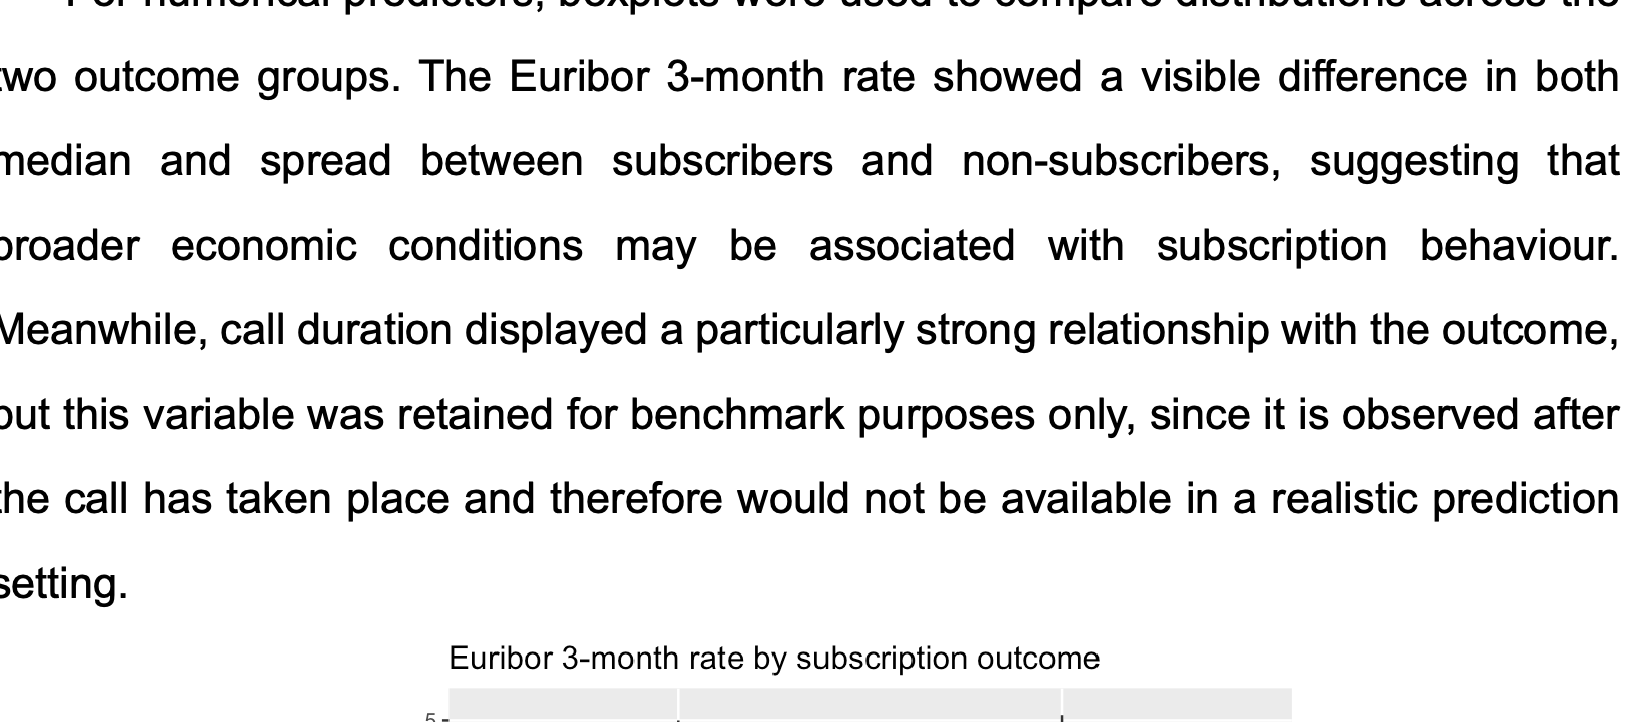
原始分析图:订阅结果下的 Euribor 3-month rate 分布。
06 / 五类模型
用不同归纳偏好比较同一个预测任务。
可解释的基线
提升单树稳定性
降低树之间的相关性
线性间隔比较
捕捉更灵活的非线性关系
07 / Random Forest 重要性
重要性反映的是预测贡献,不是因果因素。
图中 euribor3m、age、month、pdays 与 nr.employed 对预测性能贡献较高。
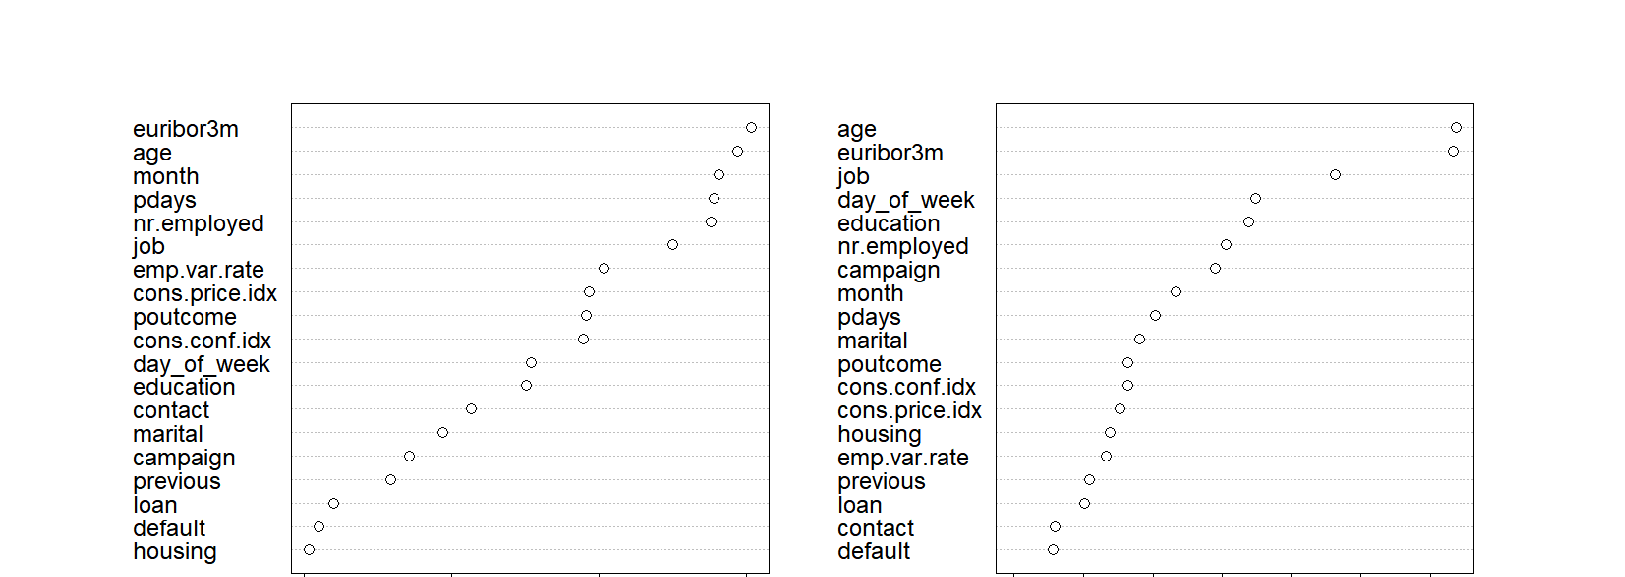
原始分析图:Random Forest 的变量重要性。
08 / 模型比较
Random Forest 整体最平衡;Neural Network 更擅长抓取潜在订阅者。
高
较低
高
较弱
平衡
平衡
平衡
弱于 RF
0.904
0.292
0.978
0.780
高
较低
高
接近 Tree
0.886
0.362
—
低于 RF
没有一个模型在所有指标上都是第一。Random Forest 因 AUC、Accuracy 与 Specificity 的平衡被选中;若业务优先捕捉更多潜在订阅者,Neural Network 的 sensitivity 更高。
09 / Final Test
独立 Test Set 上,最终 Random Forest 保持稳定表现。
10 / 业务解释
它更适合作为营销筛选与优先级工具,而非自动拨号决策器。
高 Specificity 有助于识别不太可能订阅的人,减少无效电话、人工时间和资源浪费;但较低 Sensitivity 仍会遗漏一部分潜在客户。
11 / 研究边界