苏格兰自评健康与社会经济地位研究
基于 2013 Scottish Health Survey,研究 25–64 岁成年人童年与成年社会经济地位和自评健康的条件关联。
通过顺序 Logistic Regression,追踪社会经济关联在相互调整后如何变化。
01 / 研究问题
社会经济位置与自评健康之间,哪些关联在相互调整后仍然清晰?
研究对象为 25–64 岁成年人,考察童年社会经济位置,以及成年 Education、Household Income、Household Occupational Position 和 Area Deprivation 与 good self-rated health 的条件关联;同时纳入 Age、Sex、Smoking、Alcohol 与 Long-standing illness。这里估计的是 adjusted associations,而不是因果效应。
02 / 数据概览
一个覆盖 6,323 名合资格受访者的横截面样本。
2,278 respondents
Sequential models
03 / 变量结构
一个分析结构,而不是已验证的因果路径。
Adult SEP 包含 Education、Household Income、Household Occupational Position 与 Area Deprivation。该结构帮助分组调整变量,并不宣称变量之间的因果顺序已被证明。
04 / 缺失数据
以模型各自的 complete cases 进行分析,同时保留缺失可能带来的偏差意识。
没有进行 imputation。Model 5 使用 4,981 个 complete cases,占 eligible sample 的 78.8%。被纳入者的 good health 为 37.8%,因缺失排除者为 29.5%,因此 complete-case analysis 可能存在 selection bias。
05 / 探索性模式
教育与家庭收入呈现最明显的未经调整梯度。
Degree or higher 的 good health 比例约为 47.9%,No qualifications 为 18.8%;Highest income 为 53.2%,Lowest income 为 20.2%。这些是描述性比例,不代表独立效应。
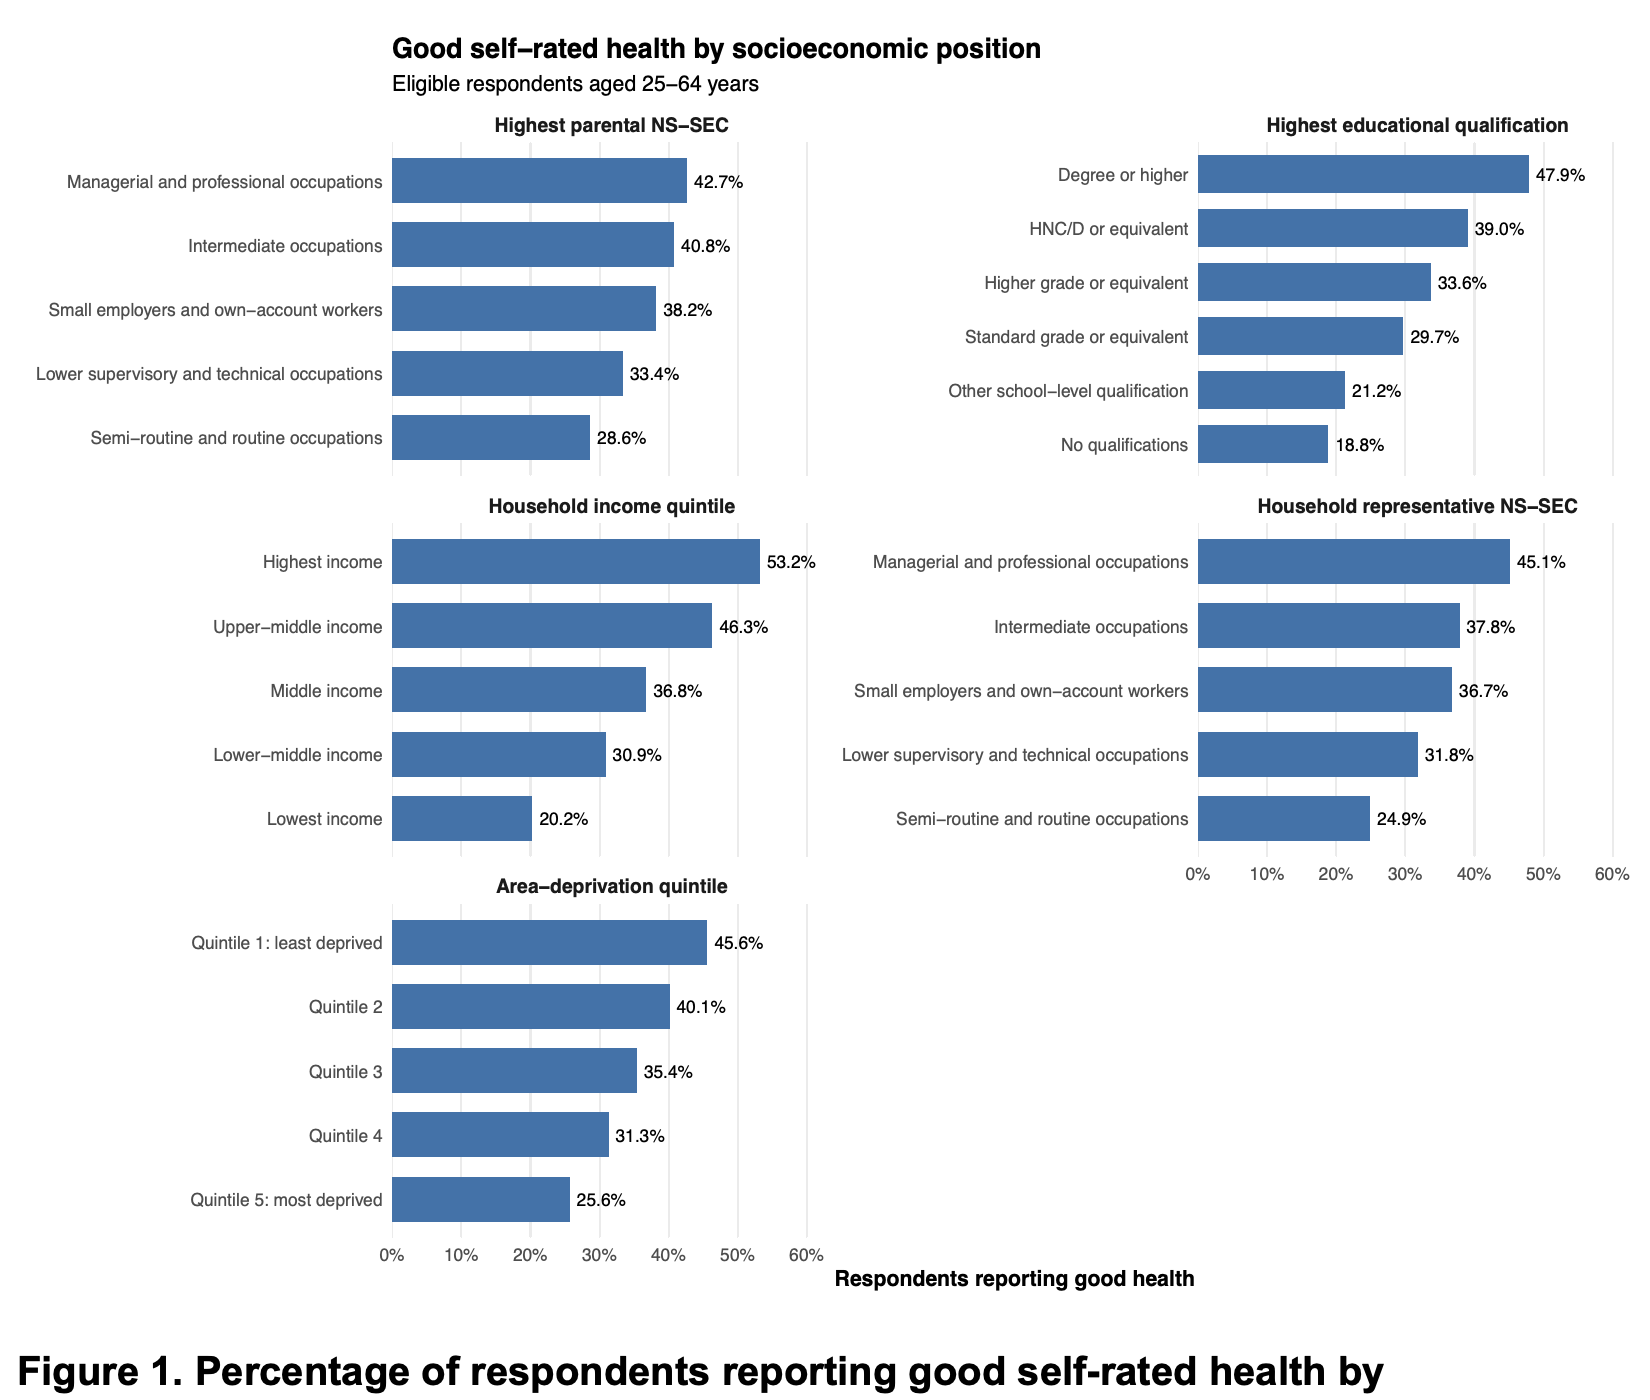
原始分析图:不同社会经济位置下的 good self-rated health 比例。
06 / 顺序建模策略
不同模型回答不同的 conditional questions。
Childhood SEP + Age + Sex
+ Education / Income / Occupation / Area deprivation
Childhood SEP + all adulthood SEP + Age + Sex
Model 3 + Smoking + Drinking
Model 4 + Long-standing illness
这些模型依据研究问题预先设计,并非通过 AIC 自动筛选;比较的重点是某个 association 在加入不同 adjustment block 后如何变化。
07 / Childhood SEP 的衰减
童年社会经济关联在成年指标共同纳入后,明显向 null = 1 靠近。
95% CI 0.52–0.70
95% CI 0.80–1.12
在 common Model 3 complete-case sample 中,Semi-routine / routine parental background 的 OR 从 0.60 变为 0.95。该 association 在相互调整后大幅衰减,反映童年与成年社会经济环境之间的统计重叠,而不是因果中介结论。
08 / 相互调整后仍然存在什么
家庭收入与教育保留了最清晰的条件关联。
95% CI 0.47–0.79
95% CI 0.26–0.41
较弱的额外证据
未见清晰的额外关联
这不表示地区贫困或童年 parental SEP “不影响”健康;仅表示在该 mutually adjusted model 中,没有观察到清晰的 additional association。
09 / Smoking、Alcohol 与 Illness
疾病信息加入后,部分表面关联明显改变。
Model 4 / Model 5
95% CI 0.33–0.48
95% CI 0.07–0.11
加入 illness 后 CI 均包含 1
Current smoking 与较低 good-health odds 的关联在 Model 4(0.51,95% CI 0.43–0.60)和 Model 5(0.52,95% CI 0.43–0.63)中保持稳定。Moderate 与 hazardous/harmful drinking 的表面正向关联在加入 illness 后减弱,不能解读为饮酒有益健康。
10 / 模型表现
随着 adjustment blocks 增加,区分能力逐步提高;这是 secondary assessment,不是诊断系统。
0.598
61.6%
Age + Sex + Childhood SEP
0.666
64.1%
+ Adult SEP
0.675
65.8%
+ Behaviours
0.768
70.0%
AIC 3865.1
Model 5 的 Sensitivity 为 59.8%,Specificity 为 76.1%,AUC 为 0.768,属于 moderate discrimination,而不是“高精度预测系统”。
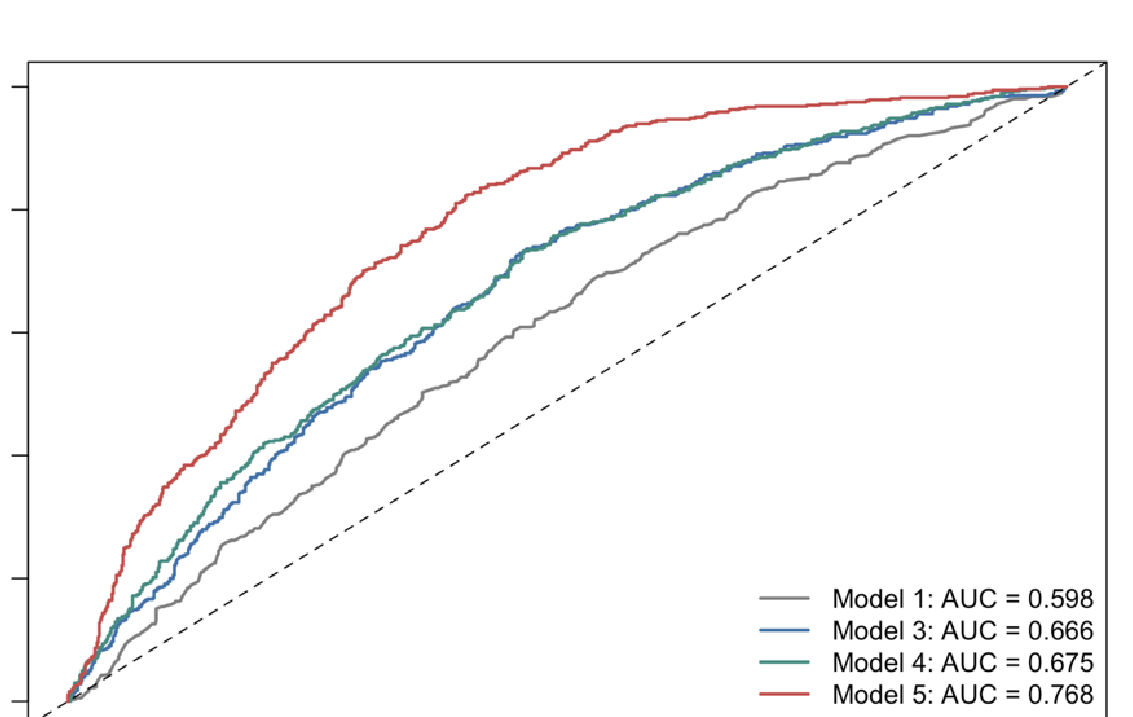
原始分析图:Models 1、3、4、5 在 test sample 中的 ROC curves。
11 / 诊断与敏感性分析
超过筛查阈值是 investigation flag,不是自动删除规则。
无明显 multicollinearity
未见超过 3 的残差
Cook’s distance / leverage
剔除 Cook’s distance 最大的 10 个 observations 后,多数 OR 变化小于 0.05;关于 parental SEP、income、smoking 与 drinking 的主要结论保持不变,说明核心结果对少量 influential observations 相对稳健。
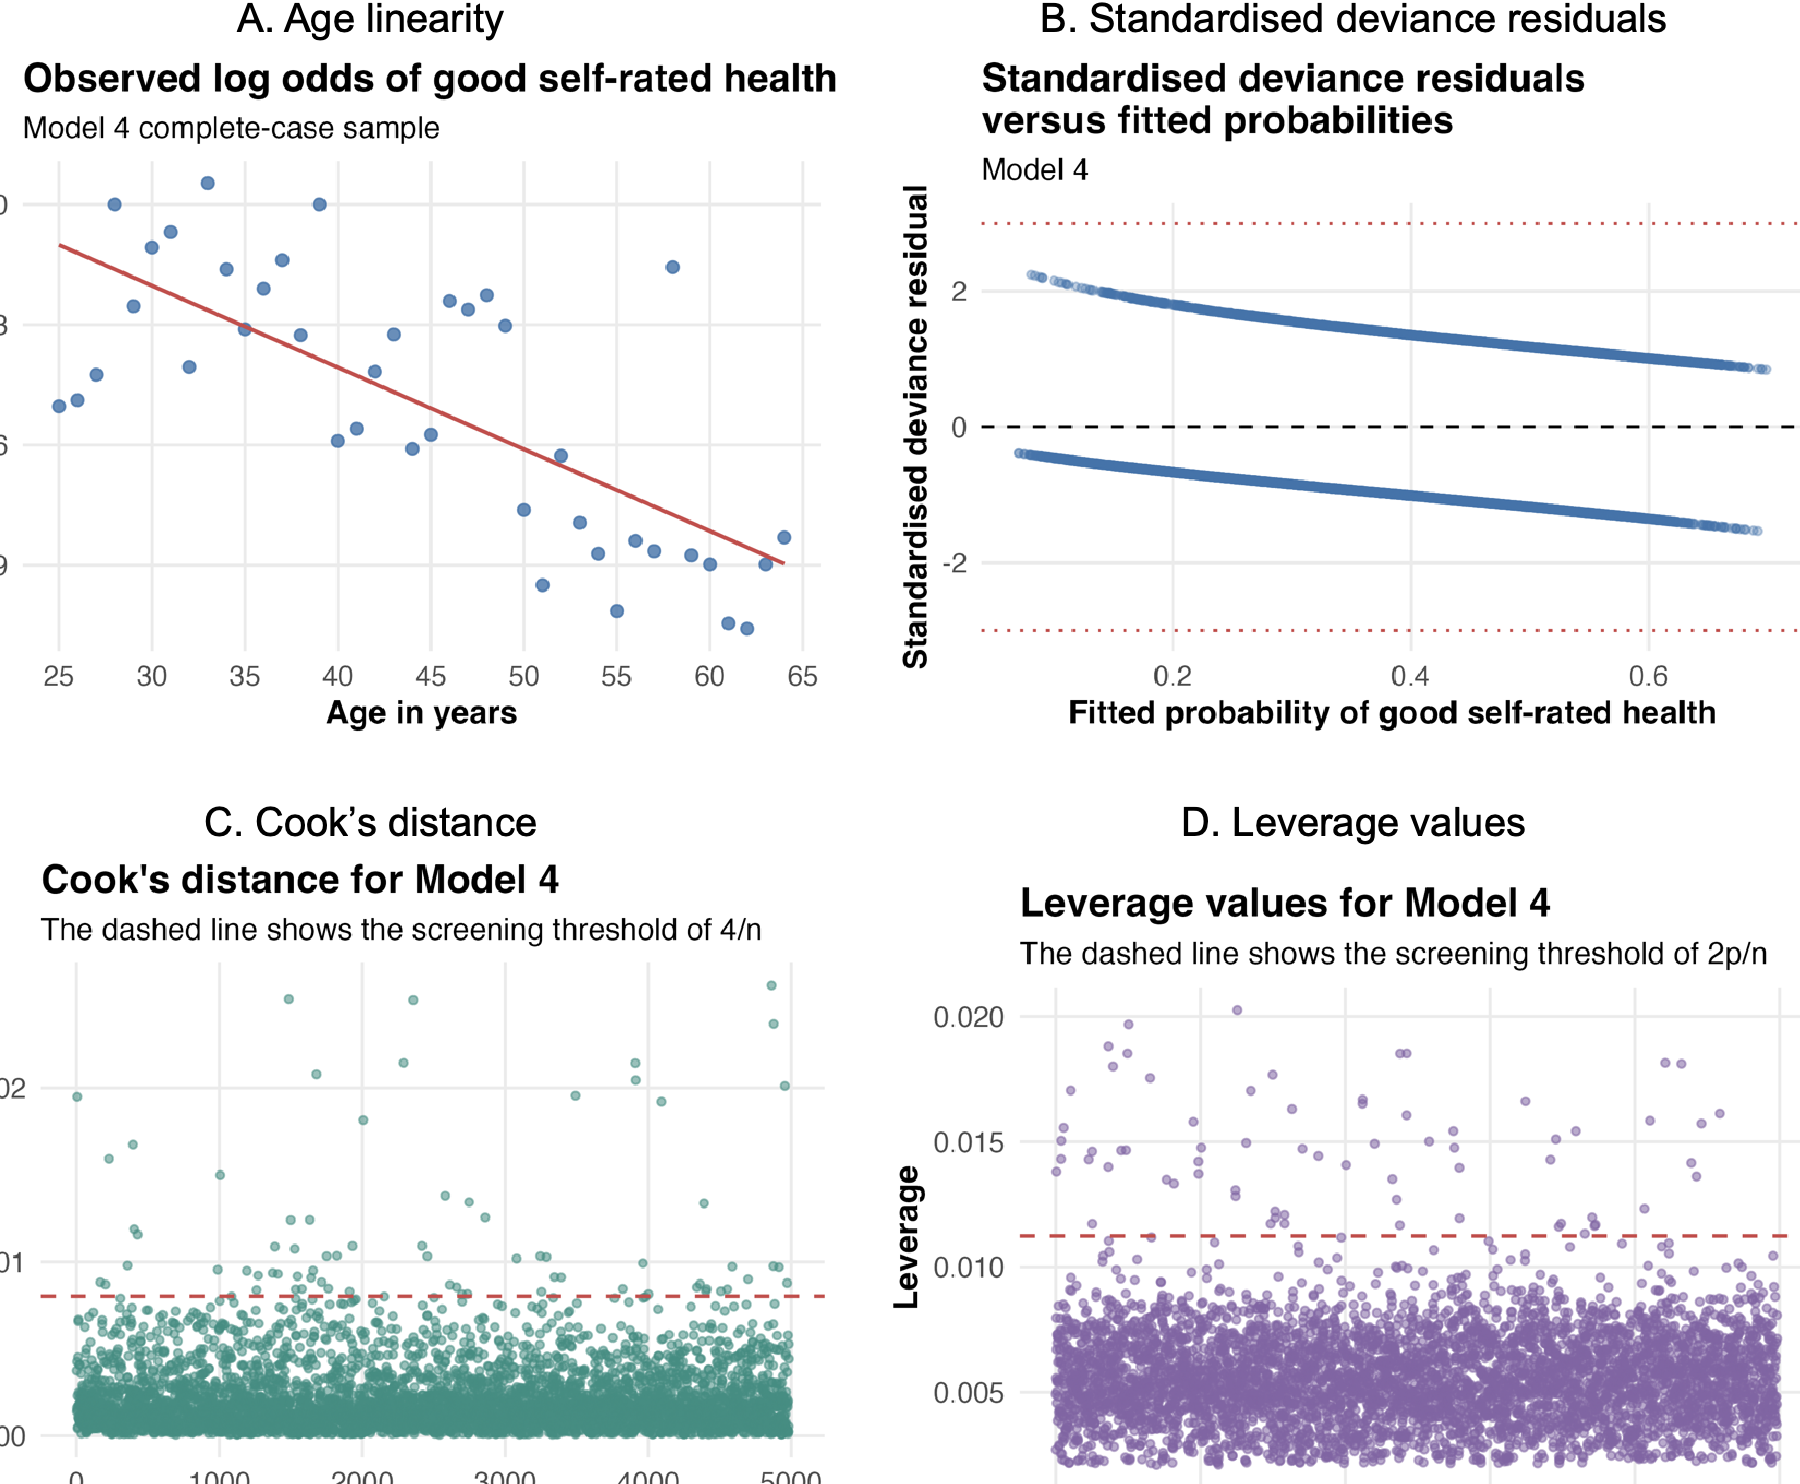
原始分析图:Age linearity、standardised deviance residuals、Cook’s distance 与 leverage 的四联诊断。
12 / 核心发现
童年社会经济差异可见,但相当一部分关联与成年社会经济处境重叠。
在成年指标共同纳入后,童年 SEP 的 association 大幅衰减;Education 与 Household Income 保留了最清晰的 conditional associations。项目的价值不仅在于拟合 Logistic Regression,更在于观察 association 如何随着 adjustment block 的加入而变化。
13 / 统计价值
14 / 研究边界