把 AI 留在自己的电脑里:我的 Personal AI Secretary 本地部署实践
把本地模型、交互界面、Knowledge 与环境感知逐步搭起来,形成一个可迁移的 Personal AI Secretary。
00 / PERSONAL AI SECRETARY
把 AI 留在自己的电脑里:我的 Personal AI Secretary 本地部署实践
我一直觉得,真正属于个人的 AI,最终不应该只是一个网页上的聊天框。
它应该认识我,能够长期读取我的资料,知道我正在做什么,也能够随着时间不断积累上下文。
更重要的是:
数据应该属于我,而不是属于某一个模型。
所以我开始搭建自己的本地 AI。
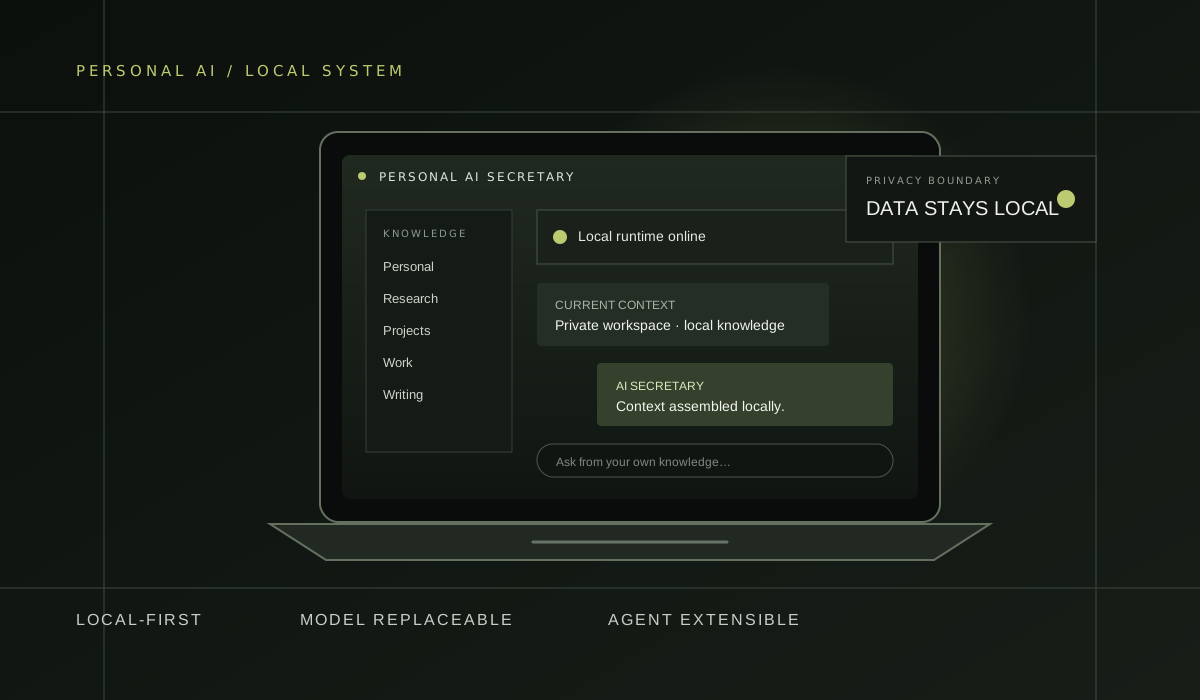
我给它的定位不是“本地版 ChatGPT”,而是一个可以不断生长的 Personal AI Secretary。
它现在还不会替我做很多事情,但从架构开始,我就希望它最终具备三个特征:
Local-first Model Replaceable Agent Extensible
也就是:
数据尽可能留在本地,模型可以随时替换,未来可以继续接入不同 Agent。
这决定了我后面几乎所有的设计。
01 / PERSONAL AI SECRETARY
1. 第一件事不是选模型,而是确定什么东西必须留下
很多人部署本地 AI,第一步都会问:
“我应该部署哪个模型?”
但我后来发现,这其实不是最重要的问题。
因为模型一定会变。
今天可能是一个 7B 模型,明天可能换成更强的模型;今天运行的是某个开源 LLM,两年以后最适合个人电脑运行的模型可能完全不同。
如果整个系统和某一个模型绑死,那么每次换模型,本质上都要重新搭一遍系统。
所以我的思路反过来了。
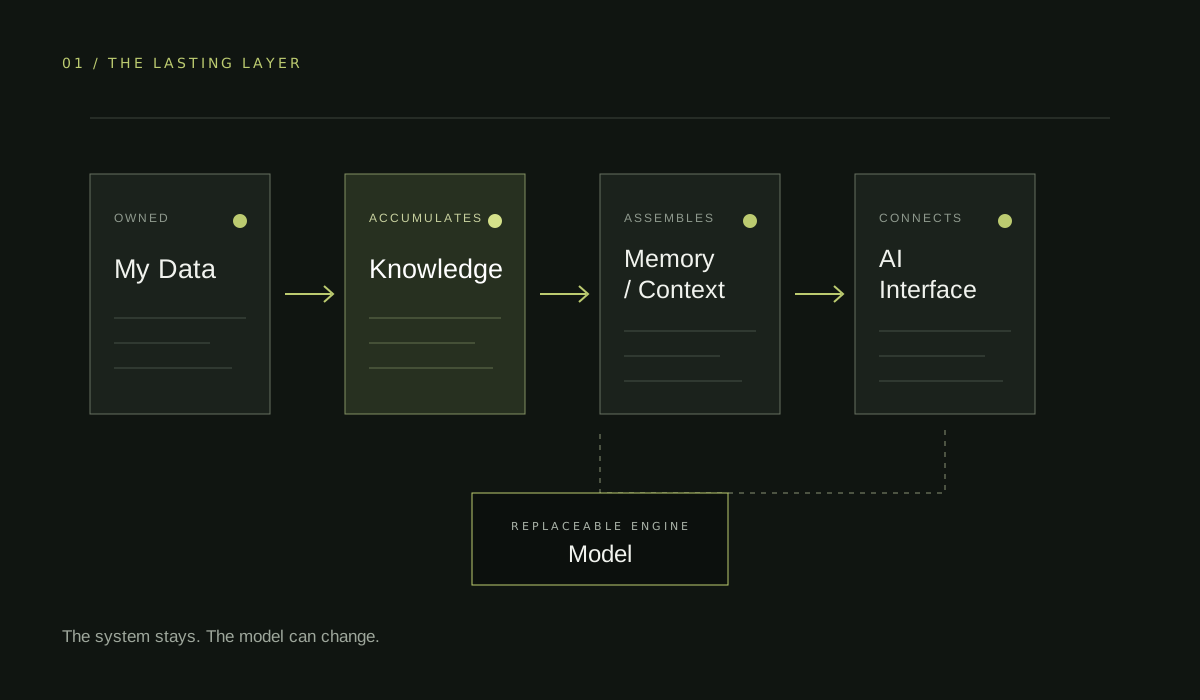
真正需要长期保留的并不是 Model,而是:
My Data
   ↓
Knowledge
   ↓
Memory / Context
   ↓
AI Interface
   ↓
Model
其中最下面的 Model 应该是一个可替换组件。
我的文档、知识、偏好和未来积累下来的个人数据,才是真正应该持续存在的东西。
于是整个项目的第一条原则确定下来:
模型不是我的 AI,数据和系统才是。模型只是其中一个可以替换的推理引擎。
02 / PERSONAL AI SECRETARY
2. 第二步:让模型真正跑在本地
确定架构以后,我才开始处理模型运行层。
目标很简单:
先让一套开源大语言模型完全在自己的电脑上运行起来。
这一步完成之后,AI 的推理链路第一次真正从云端回到了本地:
我的电脑
   ↓
Local Model Runtime
   ↓
Open-source LLM
   ↓
Response
这意味着最基础的对话不再必须经过某个云端 AI 服务。
当然,本地模型的能力未必永远比最顶级的云端模型强。
但这并不重要。
因为这一层本来就应该是可以被替换的。
以后我完全可以形成这样的结构:
Personal AI
     │
     ├── Local Model
     │
     ├── Stronger Local Model
     │
     ├── Cloud Model
     │
     └── Future Model
系统决定使用谁。
而不是某一个模型决定系统是什么。
03 / PERSONAL AI SECRETARY
3. 第三步:给模型搭一个真正属于自己的交互界面
模型跑起来以后,下一个问题马上出现了:
总不能以后每天对着终端和它聊天。
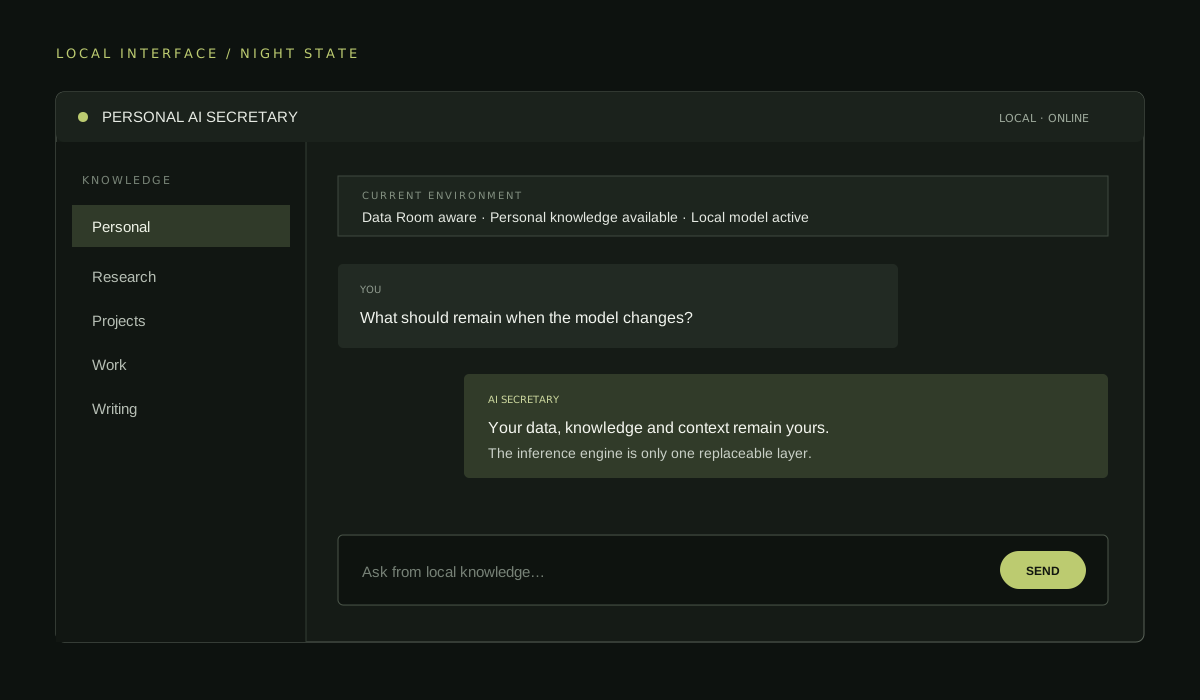
所以我开始搭建自己的 AI Interface。
这一层非常重要,因为从这里开始,它第一次不再像一个“正在运行的模型”,而开始像一个真正的软件。
我不断调整界面的布局、输入区域、信息层级和视觉状态。
甚至包括一些看起来很小的问题,比如输入文字时界面过暖、不同状态下的视觉反馈、Night 状态的呈现,我都反复修改。
因为如果一个 AI 最终真的要每天使用,那么 UI 就不是装饰。
它决定了人与 AI 之间的距离。
到这一阶段,我已经不太把它理解成一个模型 Demo 了。
它开始变成:
一个属于我自己的 AI 客户端。
04 / PERSONAL AI SECRETARY
4. 第四步:建立 Knowledge,而不是每次重新告诉 AI 我是谁
单纯拥有本地模型没有太大意义。
因为模型本身并不了解我。
每开启一次新的对话,它仍然只是一个通用模型。
所以接下来真正关键的一步,是把 Knowledge Layer 独立出来。
我为 AI 留出自己的 Knowledge 空间。
以后我的资料可以直接进入这里。
例如:
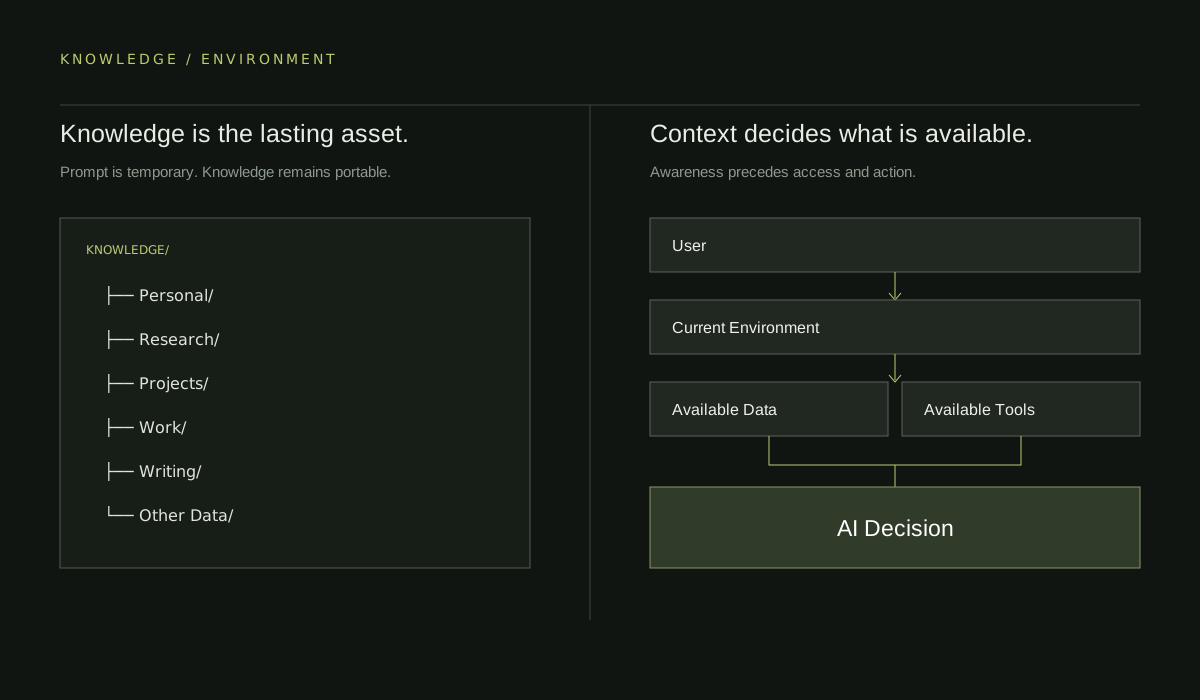
Knowledge/
│
├── Personal/
├── Research/
├── Projects/
├── Work/
├── Writing/
└── Other Data/
具体目录以后完全可以继续变化,但它表达的是一个非常重要的思想:
AI 的知识不应该写死在 Prompt 里。
Prompt 是短期的。
Knowledge 是长期资产。
以后无论模型从 A 换成 B,还是整个 AI 系统升级,Knowledge 都不应该跟着消失。
这样,我真正拥有的是:
Personal Data
      ↓
Knowledge Layer
      ↓
Retrieval / Context
      ↓
LLM
而不是:
Prompt
  ↓
LLM
这两个架构看起来只差了一层,但实际上是完全不同的东西。
05 / PERSONAL AI SECRETARY
5. 第五步:让 AI 意识到“自己正在什么环境里”
在后面的调整里,我又加入了一层我认为很重要的东西:
Environment Awareness。
例如系统中开始出现:
data-room-aware="true"它表达的其实不是一个简单的 UI 状态,而是一个更深的想法:
AI 不应该永远处于一个没有环境概念的聊天框里。
它应该知道:
- 当前是否处在 Data Room;
- 当前有什么 Knowledge 可以访问;
- 当前属于什么工作空间;
- 当前拥有什么权限;
- 当前应该使用什么上下文。
也就是说:
User
  ↓
Current Environment
  ↓
Available Data
  ↓
Available Tools
  ↓
AI Decision
这也是我后来越来越确定的一件事情:
未来的 AI Interface 不会只是 Chat。
它会逐渐变成一个 Context-aware Workspace。
聊天只不过是人与这个系统交互的一种方式。
06 / PERSONAL AI SECRETARY
6. 第六步:把“可迁移”作为系统能力,而不是备份方案
这个项目里我非常在意的一件事情,就是:
如果以后换电脑怎么办?
如果换一次电脑,整个 Personal AI 就必须重新训练、重新配置、重新喂数据,那它就并不真正属于我。
所以从一开始,我就尽量把不同部分拆开:
Personal AI
│
├── Data
├── Knowledge
├── Config
├── Interface
├── Model Runtime
└── Agent Layer
其中真正需要长期保存的是:
Data
Knowledge
Config
Personal Settings
模型 Runtime 可以重新安装。
模型文件甚至可以重新下载。
但个人数据和系统配置应该可以直接迁移。
于是未来换电脑时,理想状态不再是:
“重新搭建一个 AI。”
而是:
“把我的 AI 搬到另一台电脑。”
这两个概念完全不同。
前者是在安装软件。
后者是在迁移一个已经属于自己的数字系统。
07 / PERSONAL AI SECRETARY
7. 第七步:暂时不让它替我做事
这一点可能和很多 Agent 项目不太一样。
现在这个阶段,我并没有急着让它:
- 自动发邮件;
- 自动操作电脑;
- 自动执行代码;
- 自动管理文件;
- 自动登录各种账户。
原因很简单。
执行能力应该建立在稳定的认知系统之上。
所以我现在更看重的是:
Understand Me
      ↓
Understand My Knowledge
      ↓
Understand Current Context
      ↓
Help Me Think
      ↓
Make Decisions
      ↓
Execute
而不是一上来就:
AI
 ↓
Execute Everything
未来当然可以加入 Agent。
但 Agent 获得的应该是最小必要权限。
比如:
Research Agent
→ 可以读取 Research

Coding Agent
→ 可以读取指定 Project

Calendar Agent
→ 可以读取 Calendar

File Agent
→ 只能访问指定目录
而不是让所有 Agent 都直接拿到我的全部数据。
这是我希望未来一直坚持的原则:
Knowledge 可以集中,Permission 必须隔离。
08 / PERSONAL AI SECRETARY
8. 到这里,它已经不只是“本地部署一个模型”
整个过程走下来,我越来越意识到:
真正有意思的事情,并不是我成功把一个开源 LLM 跑在了自己的电脑上。
那其实只是第一步。
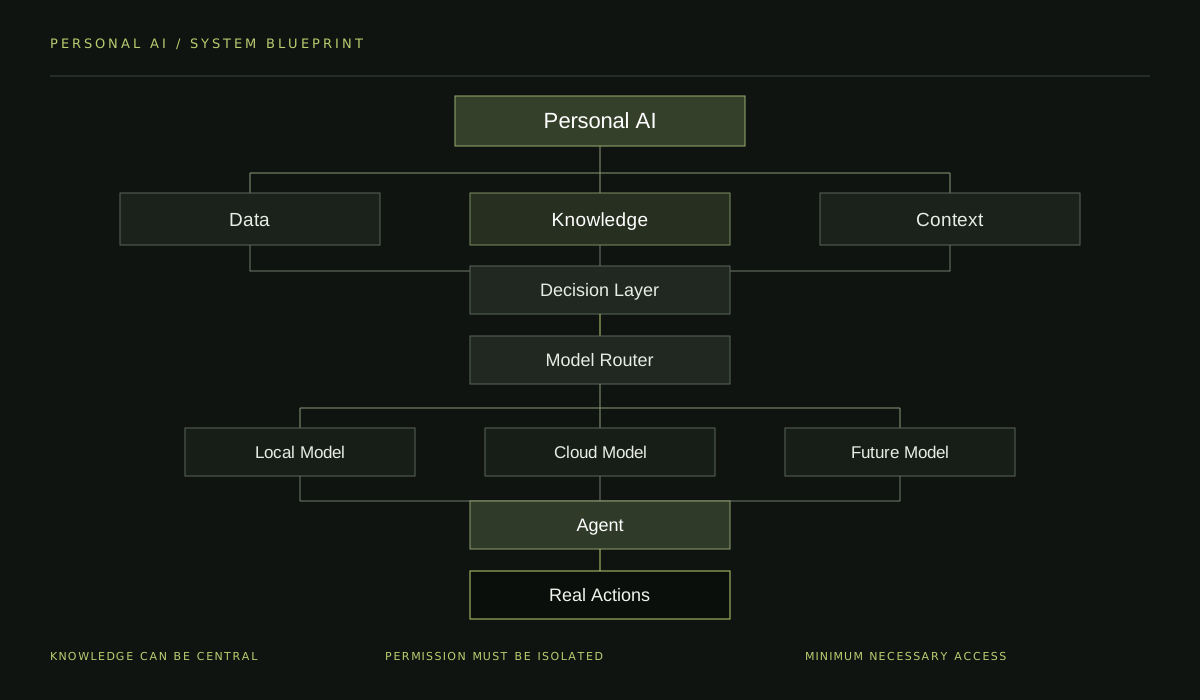
我真正开始构建的是这样一个系统:
                Personal AI
                     │
        ┌────────────┼────────────┐
        │            │            │
      Data       Knowledge     Context
        │            │            │
        └────────────┼────────────┘
                     ↓
              Decision Layer
                     ↓
               Model Router
             ↙       ↓       ↘
         Local     Cloud     Future
         Model     Model      Model
                     ↓
                  Agent
                     ↓
               Real Actions
模型只是其中的一层。
未来真正有价值的,是上面的 Personal Context,和下面的 Action Capability。
这也是为什么我现在越来越少把它称为:
Local LLM。
我更愿意叫它:
Personal AI Secretary
因为我最终想做的,本来就不是一个模型。
而是一个能够随着我一起成长、理解我的资料、辅助我的思考,并最终替我调度各种 Agent 的个人 AI 系统。
09 / PERSONAL AI SECRETARY
9. 当前阶段
目前整个系统已经完成了最基础的一轮闭环:
本地模型 → 本地交互界面 → Knowledge → Environment Awareness → Personal AI Architecture
UI 也经过了多轮调整,包括不同视觉状态以及 Night 场景。
最重要的并不是某一个功能已经有多强。
而是整个系统的骨架已经确定。
以后无论我:
换模型、
换电脑、
增加新的 Knowledge、
加入 RAG、
加入 Router、
加入 Memory、
还是接入 Agent,
都不需要推翻原来的系统。
只需要继续往里面增加新的模块。
10 / PERSONAL AI SECRETARY
结语
互联网时代,我们习惯把自己的数据不断上传到不同的平台。
平台换了,数据也就跟着换了。
账号没了,很多东西也就没了。
但 Personal AI 让我开始思考另外一种关系:
也许未来不是“我去使用一个 AI”。
而是:
“我拥有一个 AI。”
它的数据在我这里。
它认识的是我。
它使用哪个模型,由我决定。
它能够访问什么,由我授权。
它未来变成什么,也由我自己设计。
模型会一代一代地过去。
但如果架构设计得足够好,
我的 AI 不需要跟着任何一代模型一起消失。